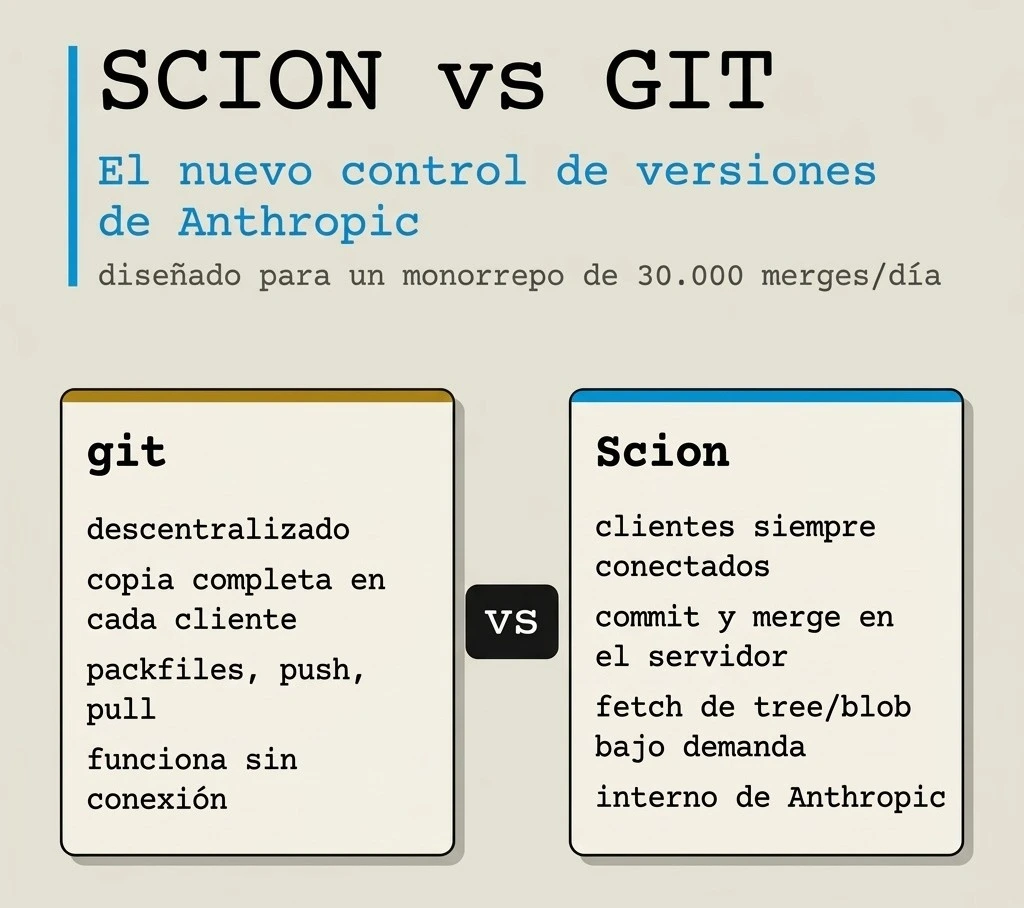
Anthropic pasó de unos 2.500 cambios integrados al día en mayo de 2026 a más de 30.000 en septiembre. Git no aguantó ese ritmo. La respuesta de Anthropic no fue parchearlo, sino reemplazarlo en su monorepo interno con un sistema nuevo llamado Scion.
Si has leído por ahí que es “la nueva Git de Claude”, conviene matizarlo desde el principio. Scion no es un producto que puedas instalar, no está publicado como software libre y, según el propio Anthropic, no es un sustituto de Git para uso general. Es una infraestructura diseñada para un caso muy concreto: un monorepo enorme, con millones de checkouts al día, donde casi todos los clientes son agentes y jobs automatizados.
Tampoco lo confundas con el proyecto scion de Google Cloud, que es una herramienta de orquestación de agentes de código. Son dos cosas distintas con el mismo nombre.
Este artículo resume la arquitectura que describe Anthropic en su publicación del 13 de octubre de 2026, con las cifras atribuidas a esa fuente. Son números internos que no puedo verificar de forma independiente, y así los trato a lo largo del texto.
Los números que rompieron Git
Según Anthropic, el historial de la rama principal de su monorepo ocupa casi 100 GB, y una copia de trabajo comprimida supera los 25 GB. Eso ya es grande, pero el problema real son los checkouts: hay unos 25 millones de checkouts de CI al día. Si cada uno se hiciera con un clon ingenuo, el tráfico de Git sería de más de 600 PB diarios, según la misma publicación.
Para aguantar eso, el equipo usó lo que tiene Git a mano: clones superficiales (--depth), sparse checkouts, remotos promisor y semillas almacenadas como blobs. Ayudó, pero llegó un punto en el que tenían varios cientos de mirrors internos de Git en funcionamiento al mismo tiempo, cada vez más difíciles de operar a medida que subía el número de merges. Además, esas semillas se desviaban de la punta de main y había que refrescarlas.
Por qué Git no encaja con agentes
La idea central del artículo es sencilla de enunciar: Git se diseñó para sistemas distribuidos y desconectados, pero en el uso de Anthropic casi todos los clientes están siempre conectados.
Git parte de que cada cliente tiene una copia completa del repositorio y trabaja sin conexión. Eso es una virtud para un desarrollador que viaja en tren. Para un job de CI que necesita un diff entre dos commits, esa copia completa es un coste sin beneficio. El modelo de Git funciona como un sistema centralizado con una copia autoritativa, pero pagando el precio de un sistema descentralizado.
Los principios de diseño que describe Anthropic van en esa dirección:
- Clientes siempre conectados. El cliente pide los datos cuando los necesita en lugar de mantener una copia entera.
- Asimetría cliente-servidor. El servidor gestiona historial, blame, commits, merges y rebases. El cliente solo guarda una caché acotada y los archivos de trabajo.
- Control de versiones como servicio. Las consultas se exponen por API, así que muchos jobs no necesitan un repositorio local. Los pipelines automáticos de bisect y revert dependen de esto.
- Escalado horizontal sin copia completa. Los datos están distribuidos y no existe una copia completa del repositorio en ningún sitio, ni siquiera en el servidor.
- Commits incrementales y sin locks. Commits, rebases y merges ocurren en el servidor, así que no hay nada que subir. El coste depende del tamaño del cambio, no del tamaño del repositorio.
Anthropic menciona como precedentes el sistema Piper de Google y Sapling de Meta.
El modelo de datos: changesets en lugar de commits
Aquí está la parte más interesante técnicamente. En Git, un commit apunta a un árbol completo, que a su vez apunta a blobs y a otros árboles. Cada objeto se identifica por el hash de su contenido. Puedes leer el detalle en el capítulo de objetos de Pro Git, que es la referencia oficial para entender esto.
Scion cambia la unidad básica. La entidad principal es el changeset, que es una entrada en un write-ahead log. En lugar de apuntar a un árbol, un changeset lista los archivos que cambiaron respecto a su primer padre, con punteros direccionados por contenido a blobs comprimidos en almacenamiento.
| Aspecto | Git | Scion (según Anthropic) |
|---|---|---|
| Unidad básica | Commit que apunta a un árbol completo | Changeset: lista de cambios respecto al primer padre |
| Almacenamiento | Objetos sueltos o packfiles que hay que mantener | Sin packfiles, sin mantenimiento de repositorio |
| Referencias | Ficheros de refs con actualizaciones de archivo | Actualizaciones compare-and-swap sobre una sola fila de Spanner |
| Creación de commits | En el cliente, luego se sube | En el servidor, sin nada que subir |
| Blame e historial de rutas | Se calcula al consultar | Estructuras derivadas precalculadas |
Lo que me parece más elegante es la separación entre datos primarios y datos derivados. Blame, historial de rutas, skip lists para el grafo de commits e índices de búsqueda por ruta no se guardan en el changeset. Se calculan a partir de él, con un mecanismo genérico: cada tipo de dato derivado se define de forma recursiva a partir de los valores de sus padres. Según Anthropic, eso permite añadir tipos nuevos, calcularlos de forma anticipada o perezosa y optimizarlos sin tocar el cliente.
El coste de ese diseño es evidente: todo depende de que la capa derivada esté bien construida y bien mantenida. Es una apuesta por la infraestructura sobre la simplicidad del modelo. Para Anthropic tiene sentido. Para un equipo de diez personas, probablemente no.
Anthropic también cita Spanner como almacenamiento, lo que tiene bastante lógica para una arquitectura de escritura sin coordinación entre servidores. Si quieres entender ese tipo de base de datos, la documentación de Spanner en Google Cloud es el punto de partida.
Arquitectura en tres niveles
Scion se organiza en tres capas que responden a la misma API RPC, así que el cliente no necesita saber en qué topología está:
scion-daemon: uno por nodo. Guarda los objetos de todos los jobs de ese nodo y arranca desde un snapshot que se refresca periódicamente.scion-cache: regional. Sirve objetos desde memoria, en el mismo formato de disco que el daemon.scion-server: la fuente autoritativa. Lee de Spanner o de almacenamiento en la nube cuando hay fallo de caché.
Anthropic hace hincapié en que las capas están estrictamente separadas para aislar fallos. Un fallo de la caché regional no debería tumbar el nivel superior. Es un patrón conocido en sistemas de caché, pero aplicado a control de versiones resulta llamativo.
El protocolo de transferencia también cambia. En lugar de un packfile de varios gigabytes, el cliente parte de un árbol raíz, comprueba qué árboles le faltan en su almacén local, los pide recursivamente y después hace lo mismo con los blobs. Las peticiones son sobre objetos inmutables, así que cualquier caché puede responderlas. Las transferencias son reanudables. Los checkouts sparse y virtualizados funcionan sin soporte especial.
Resultados que reporta Anthropic
Las cifras que publica la empresa son estas:
- Cada nivel mantiene una tasa de aciertos de caché superior al 99% y no guarda estado a largo plazo.
- La huella de infraestructura (CPU y memoria) es unas 200 veces menor que la de la infraestructura anterior de mirrors de Git.
- Los checkouts de CI e investigación pasan de minutos a segundos, es decir, unos dos órdenes de magnitud más rápidos.
- Solo en CI, la capacidad de CPU liberada equivale a un 25% de ahorro.
Mi lectura: son resultados impresionantes, pero hay que ponerlos en contexto. Son métricas internas, comparadas contra un sistema que Anthropic describe como sobrecargado por diseño, y no hay benchmarks públicos que las reproduzcan. Si tu equipo tiene un repositorio de 2 GB, estas cifras no te dicen nada sobre tu caso. Sí te dicen que el cuello de botella de un monorepo gigante casi nunca es el algoritmo del historial, sino cuántas veces copias el código.
Sin lock global: el merge queue cambia de forma
Un merge queue tradicional funciona con un lock global: un cambio entra, los demás esperan. Con 30.000 merges al día, eso no escala. Anthropic dice que no ha replicado ese lock. En su lugar confía en tests automáticos posteriores al merge y antes del despliegue. Los cambios concurrentes pueden entrar en conflicto, pero según la publicación, Claude suele arreglar esos conflictos más rápido de lo que un humano tardaría en detectarlos.
Esta es probablemente la decisión más arriesgada del artículo y la que más debate va a generar. Renunciar a la serialización estricta es razonable cuando tienes tests muy buenos y un sistema de reparación rápido. Sin eso, es una receta para romper main con frecuencia.
Antique y permisos por directorio
Anthropic construyó junto a Scion una herramienta de revisión de código llamada Antique. Su rasgo más interesante son las reglas de aprobación semánticas: pueden distinguir un cambio que solo toca comentarios de uno que modifica lógica sensible, para que los revisores humanos se concentren en lo importante.
Scion también incluye control de acceso por repositorio y por directorio, lo que permite proteger código sensible sin perder las ventajas de tener todo en un monorepo.
El papel de Claude en su propio sistema
Este es el apartado más autopromocional del post original, así que conviene leerlo con cierta distancia. Anthropic cuenta que varios componentes se desarrollaron con ayuda de modelos internos, entre ellos Claude Mythos Preview:
- Los ingenieros escribieron a mano un prototipo del pipeline que importa el historial de Git a Scion. Una versión temprana de Mythos Preview lo reescribió usando 20 veces menos memoria y ejecutándose 4 veces más rápido, manteniendo los invariantes de orden y de estructura de datos.
- Claude encontró una mejora algorítmica en las consultas de ancestros que había pasado por alto un índice. Según Anthropic, un experto habría tardado días o semanas.
- Claude ayudó a construir simulaciones herméticas de la infraestructura, además de pruebas de fuzzing y de límites de tasa.
- Agentes de Claude vigilan componentes concretos, como
scion-daemon,scion-cacheo la cola de merges de Antique, a través de canales de Slack, usando telemetría y logs.
Lo que me parece más honesto del post es que los ingenieros dicen que muchas veces tuvieron que decirle a Claude que no. Cuando el modelo proponía sobreingeniería basada en problemas hipotéticos o violaba restricciones del sistema, lo frenaban. Y el trabajo de revisión pasó a centrarse en la intención de los cambios más que en cada línea.
Según la publicación, el equipo fue de siete ingenieros, que construyeron Scion, Antique y unos seis sistemas más, y completaron la migración en cinco meses mientras el volumen de merges crecía unas diez veces.
Lo que sí puedes aplicar hoy
No vas a montar Scion en tu proyecto, pero algunas ideas son transferibles con las herramientas que ya tienes.
Clones parciales y sparse checkouts para que CI no descargue todo el historial:
git clone --filter=blob:none https://github.com/org/monorepo.git
cd monorepo
git sparse-checkout set services/api
Worktrees para trabajar en paralelo sin copiar el repositorio entero. Es la misma idea de no duplicar el repositorio, aplicada a escala humana o de agente. Un worktree comparte el historial pero tiene su propia carpeta de trabajo y su propia rama:
git worktree add ../monorepo-feature-x -b feature/xClaude Code también tiene soporte nativo para worktrees en sesiones paralelas, que crea en .claude/worktrees/. Ten en cuenta que un worktree no incluye archivos ignorados como .env, así que hay que copiarlos y reinstalar dependencias en cada uno.
[EXPERIENCIA: ¿has usado worktrees o sesiones paralelas de agentes en algún proyecto? Qué problemas te encontraste]
Mi opinión
Creo que el artículo de Anthropic es valioso por su honestidad técnica y por lo que deja implícito. Hay tres cosas que me llevo.
Primera: el cuello de botella real es la copia. Git no es lento en el historial. Es lento cuando millones de procesos piden copias completas de algo que solo necesitan en parte. Scion resuelve eso moviendo la lógica al servidor. Eso es una lección de arquitectura que vale para casi cualquier sistema distribuido.
Segunda: los agentes cambian los supuestos. Git asume humanos que trabajan offline, revisan cambios despacio y hacen pocos commits al día. Un agente hace cientos de cambios, necesita leer el repositorio desde una API y no tiene sentido que mantenga una copia local. Si tu flujo de trabajo empieza a parecerse a ese, el modelo de Git empieza a estorbar.
Tercera: me preocupa la moda de copiar soluciones de escala ajena. Scion está diseñado para 25 millones de checkouts diarios. Casi ningún equipo tiene ese problema. Lo sensato es coger los principios (no copiar, no mantener mirrors, cachear por contenido) y aplicar las herramientas estándar: clones parciales, sparse checkouts y worktrees. Para el 99% de los equipos, eso es suficiente.
Anthropic dice que quiere compartir sus ideas para que el ecosistema de Git adopte partes del enfoque: RPCs del lado del servidor en plataformas como GitHub o GitLab, un protocolo de descarga renegociado y funciones de sparse y shallow que se compongan mejor. Si eso llega a Git de verdad, será más relevante que el propio Scion.
Fuentes y lecturas
- Redesigning source control at Anthropic, publicación original de Anthropic, 13 de octubre de 2026
- Anthropic reinvents source control as Claude floods the world with code, cobertura en Slashdot
- Anthropic unveils Scion, the source control system that replaced Git, resumen en Pasquale Pillitteri
- Mark Kretschmann en X sobre el crecimiento de merges
- Pro Git: Git Objects y Pro Git: Packfiles
- Documentación de git worktree
- Documentación de git clone, incluido
--filter - Documentación de git sparse-checkout
- Sapling SCM, el sistema de Meta
- Run parallel sessions with worktrees, Claude Code Docs
- Proyecto scion de Google Cloud Platform, para no confundirlo con Scion de Anthropic
